国产智能眼镜正面临一个尴尬的境地:摄像头像素越来越高,翻译语言涵盖几十种,AI功能越来越丰富,但用户的新鲜感过后,这些设备往往被闲置在角落里。
IDC最新公布的数据透露了一些信号:2026年第二季度,全球智能眼镜出货量同比增长35.3%,而中国市场首次出现了8%的同比下滑。其中,音频及音频拍摄眼镜品类下降了35.4%。功能同质化与产品迭代不足导致该品类触到了天花板。
这并不意味着AI眼镜是个伪命题,而是行业不得不面对的一个常识问题:拍照和翻译可以吸引用户尝鲜,但不足以支撑日常佩戴的需求,无法提升智能眼镜的活跃度。
10月13日,阿里千问在杭州带来了一轮新的尝试。
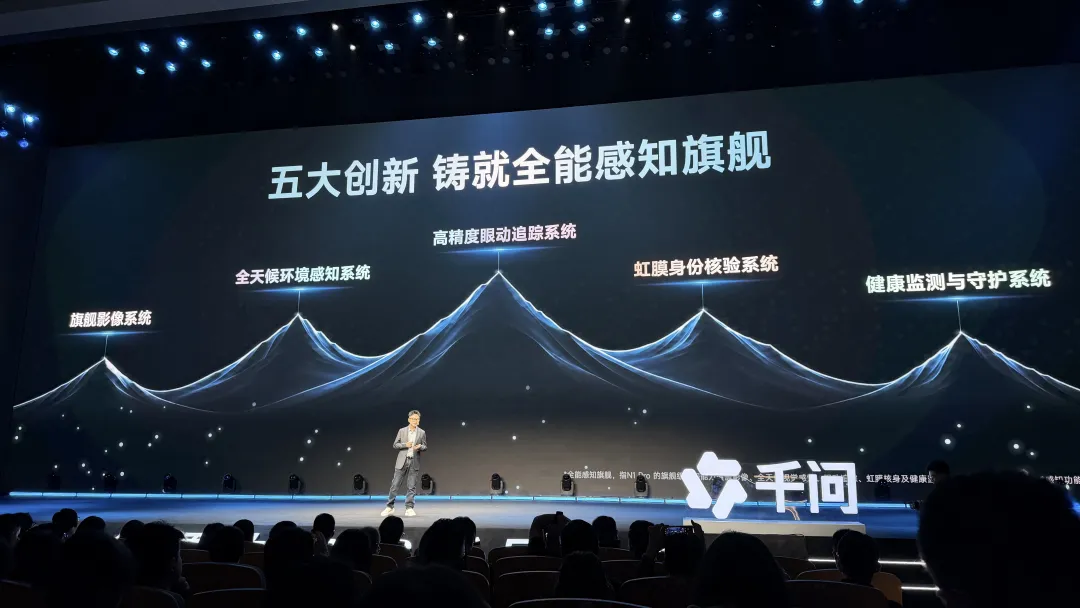
当天,千问正式开售新一代AI眼镜N1、N1 Pro,以及与Bose合作推出的首款AI耳夹式耳机。叠加国补及限时优惠后,N1到手价2218元起,N1 Pro为2600元起,耳机则压到了1099元。
N1上手时,最直观的感受是久违的轻巧。相比之前带有双目显示屏、内置微型光机S1,新一代N1系列彻底取消了显示屏,主要交互方式变为语音。
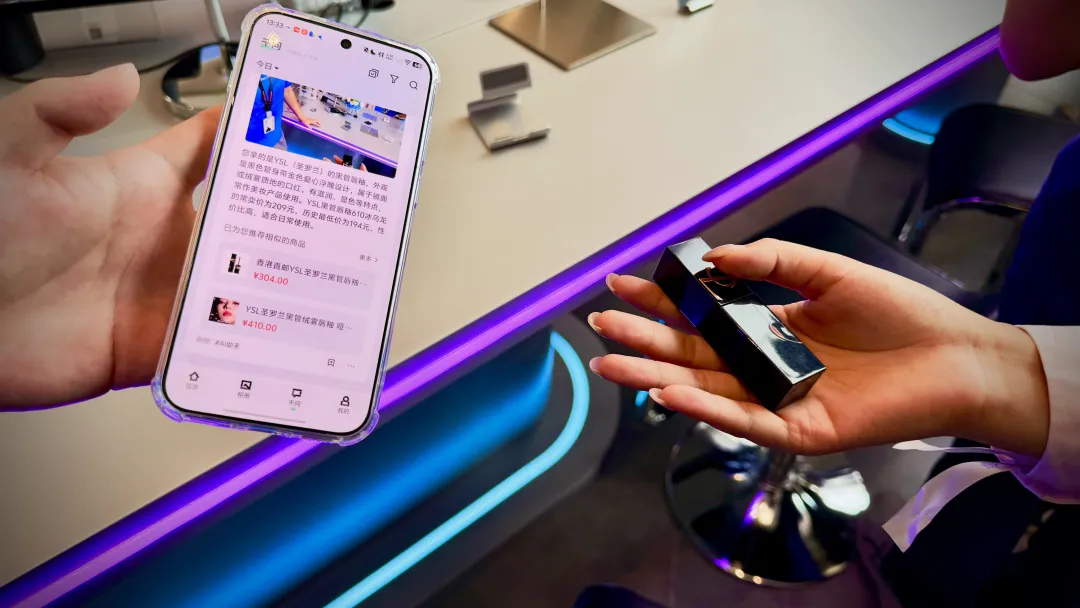
这使得N1 Pro在配备了5000万像素传感器、眼动追踪模组和体征传感器等多组件的情况下,整机不含镜片的重量依然控制在44g左右。过去戴智能眼镜常见的“压鼻梁、留红印、戴10分钟就想摘”的痛点得到了极大的缓解。
千问将这条产品路线定义为Personal Agent硬件,其逻辑在于:如今的大模型越来越擅长处理复杂任务,但在现实世界中,它依然是一个对眼前人一无所知的“局外人”。因此,除了影像和佩戴体验的升级,这次千问试图为AI补充一种长期缺失的能力:理解用户在现实世界中的即时上下文。
为此,千问引入了仅5毫瓦功耗的持续视觉感知链路,并通过眼动追踪、体征监测和耳机语音交互,使Personal Agent从手机App进一步走进日常生活。
5毫瓦实现常驻视觉感知
过去几年,AI眼镜普遍采用“按需唤醒”(Click-to-wake)的交互模式,本质上是对电池物理法则的妥协。如果让高分辨率CMOS传感器和多模态视觉模型在端侧全天候运行,不仅会在半小时内耗尽电池,还会变成一个架在鼻梁上的“暖手宝”。
千问给出的工程解法是避开大芯片的硬抗,另外开辟了一条完全独立的低功耗常驻感知链路。
这套系统的底层逻辑不是在端侧全天候运行复杂的视频大模型,而是通过极严苛的算力分级来平衡功耗:
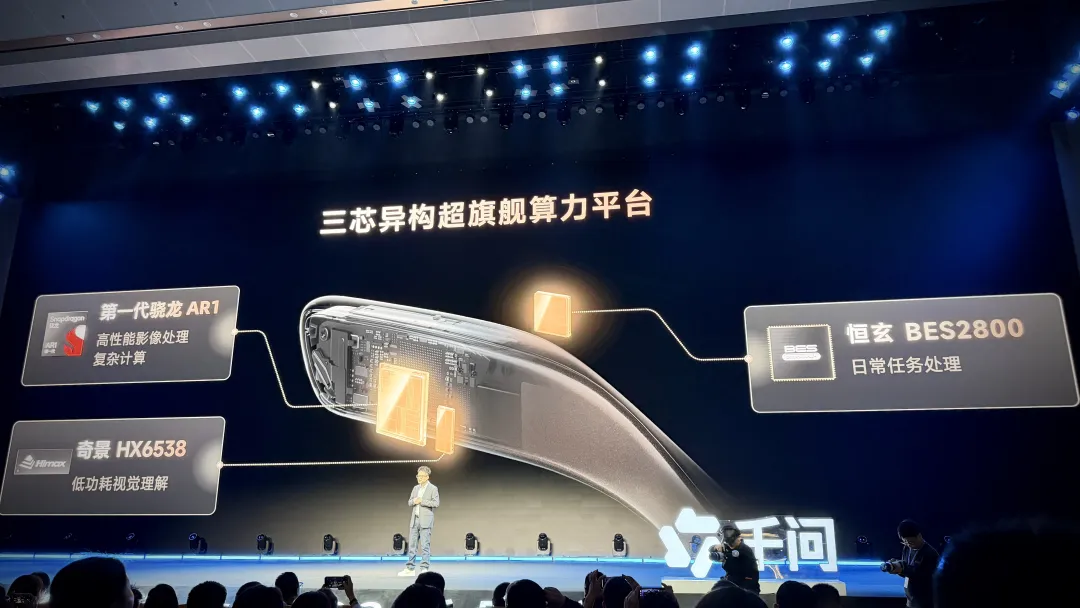
5毫瓦的常驻感知功耗:采用第一代骁龙AR1、恒玄BES2800和奇景HX6538组成的算力异构平台,其中低功耗感知芯片常开待命,只抓取极简的灰度帧轮廓,整条常驻通路的功耗被控制在5毫瓦左右;
按需阶梯唤醒:5毫瓦链路只负责监测物理环境的特征跳变。只有当它识别到用户预设或授权的关键场景线索(例如进入会议室、到达车站闸机),才会分级唤醒负责通信、音频乃至高负荷影像计算的高性能芯片。
值得强调的是,低功耗感知并不等同于“无死角的偷窥与全天录像”。在体验展台,工作人员特别阐述了这套系统的隐私保护边界:Always On模式必须由用户手动授权开启;在常开状态下,仅采集像素级灰度帧;感知阶段只提取必要的场景特征,在端侧完成基础判断,不默认上传。
至于发布会上引发关注的“AI灵感画集”,能自动抓取日常生活高光碎片并转化为漫画风格的日常Vlog功能,技术团队也坦承,目前团队正优先打磨这种宽容度高、偏情绪价值的生活记录场景。
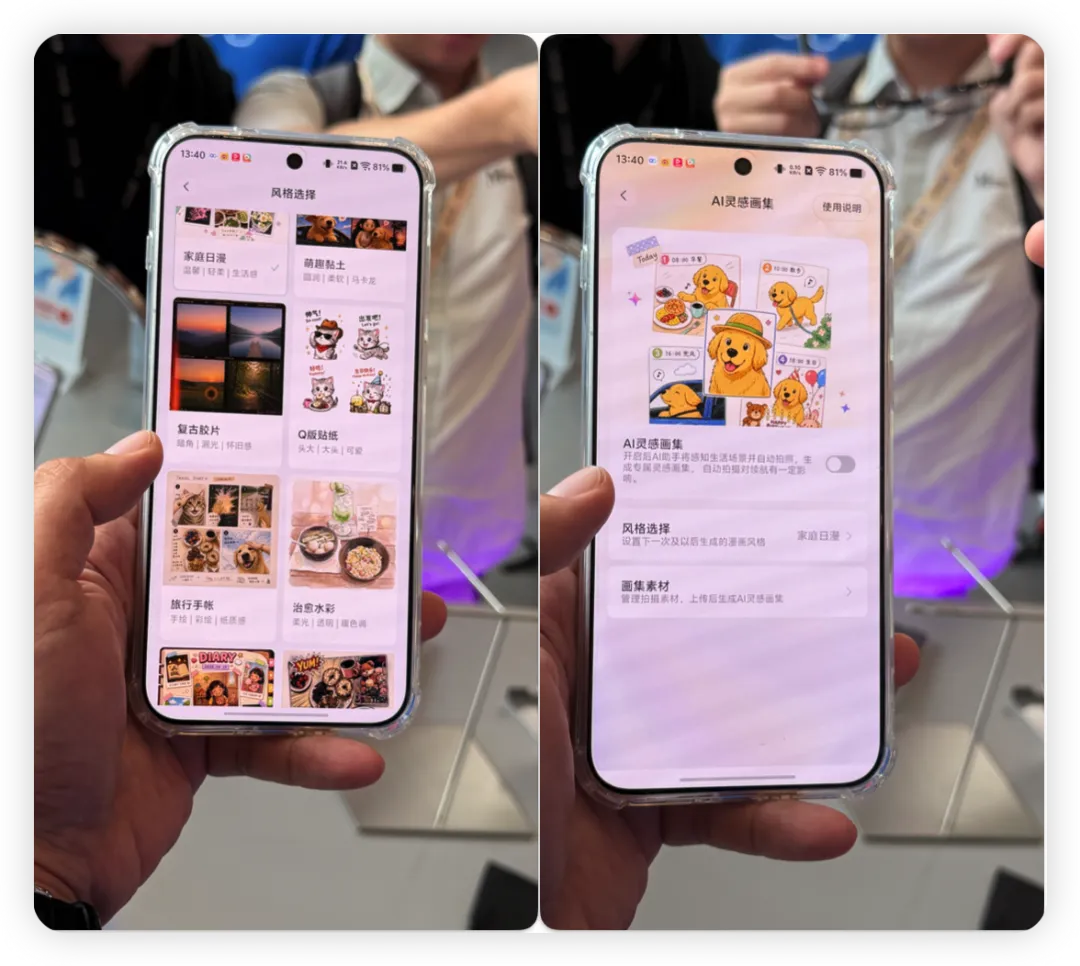
要让AI在几毫瓦的限制下完全做到无死角、连续的“全场景纪实理解”,在长尾场景算法的泛化性上,行业依然处于攻坚爬坡期。
比功能更难的,是让AI真正随身
能够感知环境,只解决了问题的一半。另一半是,用户是否愿意一直佩戴,以及当AI尝试提供服务时,体验能否足够自然。
在现场体验中,最直观的改变是N1系列彻底走向了无屏设计。相比之前配有双目显示模组的S1,新一代产品终于退回到了普通眼镜的克制形态。对于戴过智能眼镜的用户来说,鼻梁的压迫感往往比任何技术参数都更能决定一件产品的生死。
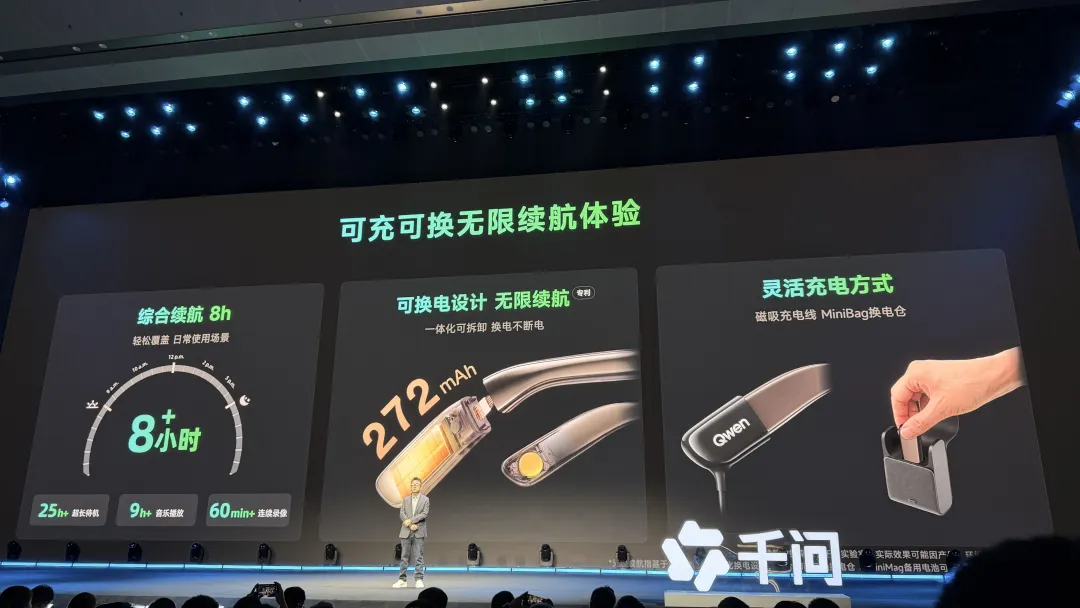
N1 Pro把镜腿宽度压到8毫米,通过前后1:1的配重将整机不含镜片的重量控制在44克左右,配合镜腿热插拔换电,实现了8到9小时的综合续航。这些工程取舍与其说是为了冲指标,不如说是先用减法为“全天佩戴”扫平最基础的生理障碍。
这种减法带来的直接变化是极大地降低了记录对当下生活的打断。正如旅行博主房琪在现场分享的那样,过去用相机或手机记录,看到光线第一反应是找机位,走进巷子便开始构思文案,人反而在取景框背后与现实脱节。第一视角记录的核心价值,从来不是去卷手机相机的成片画质,而是让人不必从眼前的场景中抽离。
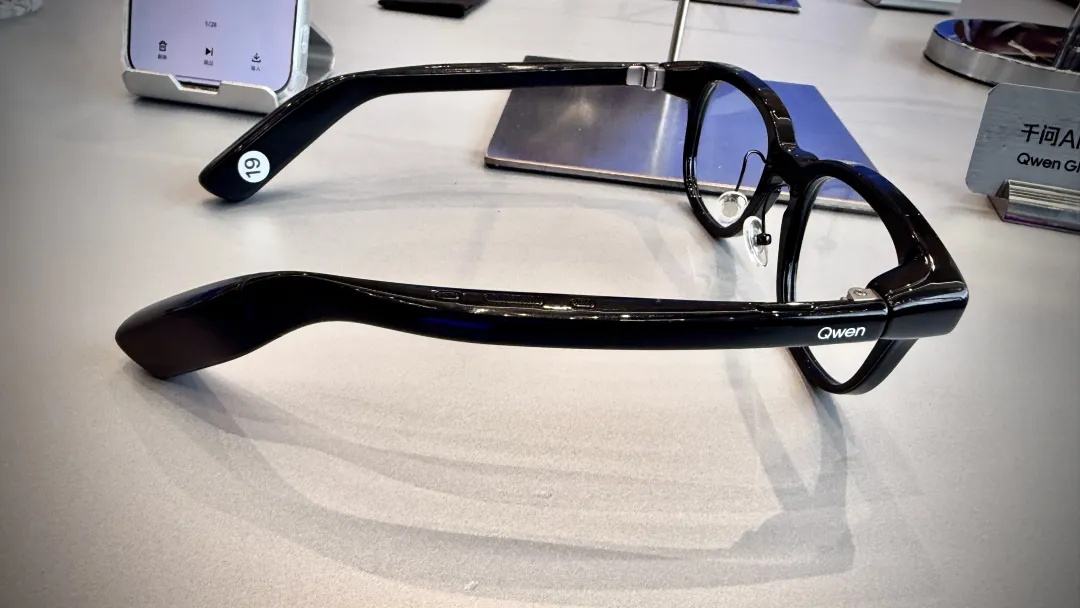
不过,丝滑体验的背后同样存在现实挑战。在现场体验中,相比实体按键拍照的干脆,依赖语音唤醒和端云多模态理解的交互,往往伴随着一两秒的等待,且极度依赖现场网络。这也印证了当前AI硬件的真正门槛:不是塞进更多功能,而是如何让感知、理解到执行的链路足够快,快到让计算彻底在用户的意识里隐形。
如果说,N1眼镜负责截取视觉上下文,那么千问首次推出的AI耳夹式耳机,则把触角伸向了听觉与行动层。由Bose调音,除了在开放式形态下守住低频与清晰度,真正承载Personal Agent属性的是“异步任务交办”能力。
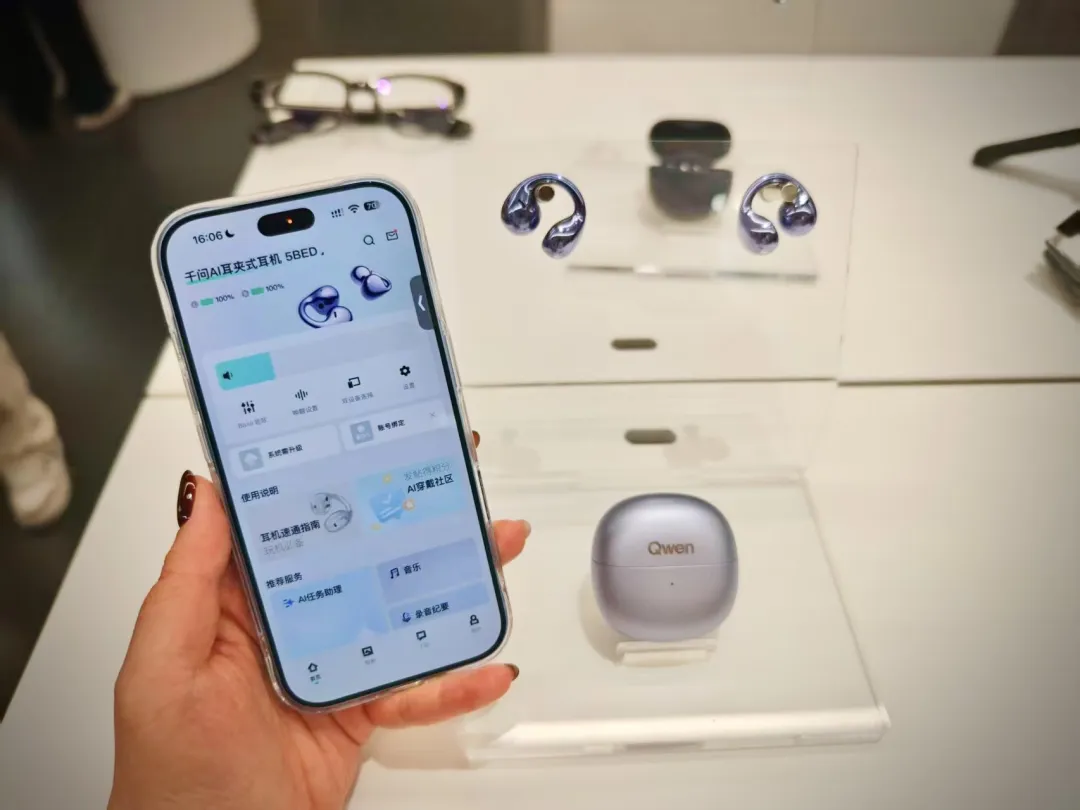
以往的语音助手之所以迅速沦为摆设,是因为它把交互困死在“一问一答、原地等待”的机械模式里。千问尝试改变这种逻辑:晚高峰通勤途中,佩戴者无需紧盯屏幕,只需对耳机随口交代一句“帮我跟进今天千问发布会的信息,梳理行业观点做个简报发我”,大模型便在后台自主跑完检索、阅读与整理的长链路。
任务完成后,耳机只在关键节点轻声提示任务完成状态。耳机不再是一台简单的放音设备,而是变成了随身的轻量级任务工位。
争夺物理上下文
“专属感不是AI要知道得更多,而是它得知道什么与你有关。”千问硬件负责人吴建军在现场的这句话点破了Personal Agent硬件的内核,也直击当下大模型厂商共同的痛处。
如果始终被困在手机屏幕和PC浏览器背后,大模型即便拥有再庞大的参数规模,抓取到的数据也始终是转述的、二手的。它或许知道你在电商平台买了一件外套,知道你在输入框里修改了三次的措辞,但却不会知道,你在路过巷子口面店时视线停留了三秒,更不知道你在高压工作下的心率与体温的起伏。
缺少物理世界的原生感官,大模型就永远无法拼凑出真实完整的意图图景,只能沦为一个在数据中心里被动等待提问的应答机。
此时去断言大模型在物理世界的理想“肉身”究竟该是什么形态,或许为时尚早。现场体验中对网络稳定性的依赖、端侧模型解析复杂现实时的粗粝感,以及高阶体征监测与虹膜核身受限于成本被锁在Pro版的现实,都说明硬件的演进依然处于早期攻坚阶段。
但朝向真实世界的试探正当其时。千问交出的这份答卷,不再试图在眼前强行架起一块遮挡现实的显示屏,也没有让产品困死在随身相机与翻译笔的狭窄叙事里。通过剥离冗余的减法、44.8克的轻量克制,以及5毫瓦在底层的耐受,它让硬件退后了一步,让感官向前走了一步。