智能体正在成为新的开发者平台,它们利用来自 Git、Slack 和 Jira 等工具的语义搜索数据来获取上下文信息。在 欧洲 KubeCon & CloudNativeCon 大会上,Whitney Lee 和 Viktor Farcic 在演讲 AI Meets Internal Developer Platform 中讨论了设置护栏来阻止或允许智能体的某些操作,以及使用日志、指标和追踪来理解智能体的行为。
Farcic 认为,智能体将是平台领域的下一场革命。以前是 Backstage,现在则是智能体,为企业提供开发工具。
Farcic 解释说,智能体接收开发者的输入,将其与系统上下文相结合,然后发送给大模型。大模型做出响应并提供答案,或者根据对工具能力的描述来调用工具:
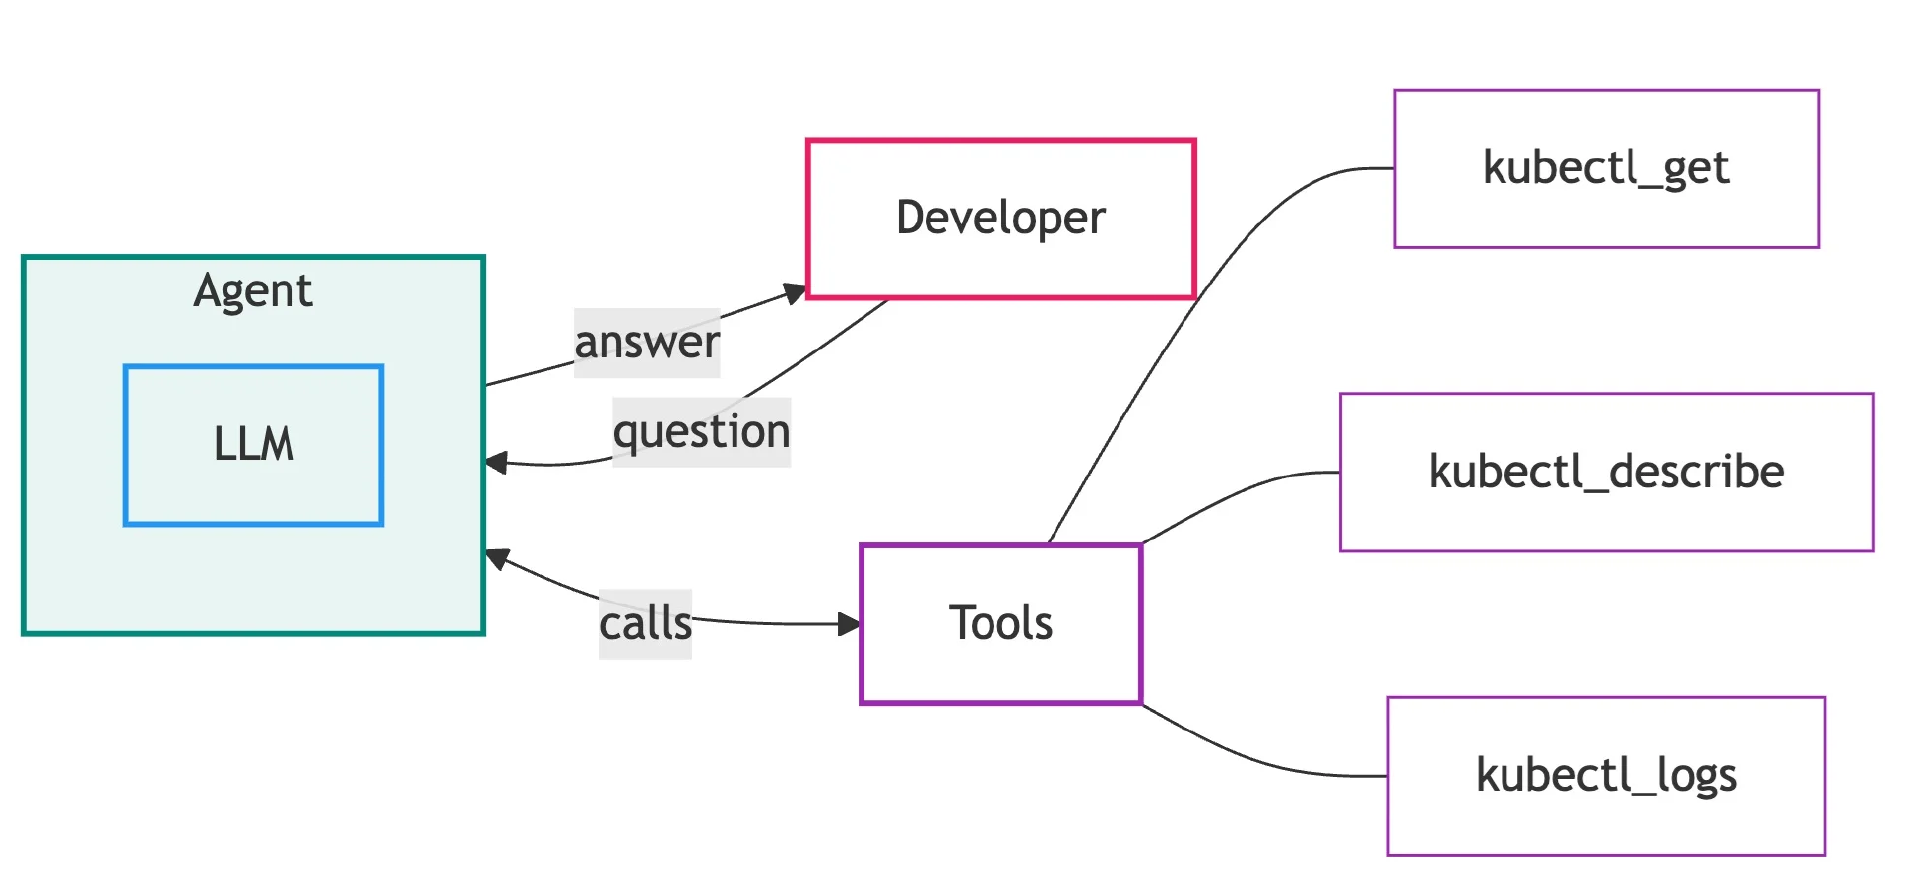
Farcic 说,语义搜索使智能体能够在特定时刻找到所需的信息:
信息来源可以是任何东西:包含清单和代码的 Git 仓库、PR 讨论记录、有人解释过为什么不使用某个数据库的 Slack 会话、Jira 工单、设计会议的 Zoom 记录。团队 “行事规范与经验惯例” 就蕴藏在这些资料中。
企业正在搭建自己的智能体来保障安全。Farcic 提到,希望有某种护栏来阻止或允许某些事情,有些事情可以由系统自动执行,有些事情则需要特定的批准。
Farcic 说,对于大语言模型,输入可以是用户提供给智能体的任何内容,输出则是大模型认为它应当执行的动作。他补充说,无法预测输入或输出的具体内容,也无法限制会发生什么。
Lee 说,智能体链路追踪能够让开发者与平台之间的交互过程变得可观测。它们可以展示智能体使用了哪些模型、选择了哪些工具、这些调用的 token 成本,以及完成任务所采取的路径。
Farcic 建议通过日志、指标与链路追踪在智能体层面采集运行事件:
链路追踪能够展示请求从用户传递到智能体、再到各类工具的全过程。这可能是事件发生后还原并理解整个过程的唯一手段。
Farcic 解释道,OpenTelemetry 提供了生成式 AI 专用语义规范;包括模型调用的 span(包含模型名称、token 计数、工具调用及其参数):
使用 OpenTelemetry,可以将数据发送到任何地方:链路追踪数据可接入 Jaeger 或 Grafana Tempo,指标数据接入 Prometheus,日志数据接入 Loki。商业版平台——Datadog、Honeycomb、Dynatrace、Elastic——也都支持 OpenTelemetry。
Farcic 总结道,真实的追踪记录就是测试数据。开发者实际提出的问题、智能体真实走过的执行路径构成了一个评估集,远比在会议室里编造的任何数据集都要好。
InfoQ 在演讲后采访了 Whitney Lee 和 Viktor Farcic。
InfoQ:如何通过语义搜索获得好的结果?
Viktor Farcic: 语义搜索的质量不是由嵌入模型或向量数据库决定的,而是由放入索引的数据以及数据的切分方式决定的。
第一个误区是假设文档就是来源。文档只是其中一个来源,而且通常是最糟糕的一个,因为文档很容易过时。
第二,文本分块。如果将一份四十页的文档作为单个向量嵌入,会得到一个泛泛覆盖所有主题但对任何具体内容都描述不准的大杂烩。把它切成能够独立存在的片段——一个章节、一个函数、一个资源定义——并保留元数据:属于哪个仓库、哪个团队、以及时间戳。
第三,时效性。索引不是运行一次就完事的迁移任务。如果信息是六个月前的,智能体就会自信地给出六个月前的答案,这比没有答案更糟糕,因为你会信任它。摄取必须是持续进行的,删除操作也需要同步传播到索引。
最后,知道什么不应该放在索引中。语义检索用于搜索知识。集群的当前状态不是知识,它是状态,而且每秒都在发生变化。不要嵌入它们,而是给智能体一个工具来实时获取。
还要做指标观测。查看链路追踪,确认某个问题实际召回了哪些文本块。当答案出错时,问题往往出在检索环节,而不是大模型。
Whitney Lee: 向量搜索能够从各类工具中取回信息。作为用户,你(或者更可能是你的编码智能体)不需要理解信息放在哪里,而且因为信息是通过语义相似性来索引的,你不需要猜测使用了什么确切的词汇来找到你要找的东西。
InfoQ:如何在 AI 应用中使用链路追踪?
Lee: 单条链路追踪可以告诉你智能体做了什么,这有助于调试。查看数千条链路追踪可以告诉你开发者如何使用平台。
大规模采集智能体链路追踪数据时,智能体可观测性就转变为平台洞察能力。追踪数据会告诉平台团队开发者希望借助平台完成哪些任务。这就创建了一个反馈循环:开发者与智能体交互,链路追踪显示智能体和平台的响应情况,综合这些信息,平台团队就能找到优化开发者体验的方向。
Farcic: 对于普通的应用程序,当发生崩溃时,可以用相同的输入来重新运行,然后看着它再次发生崩溃。对于智能体,你不能这样做。问同样的问题两次,你会得到两条不同的执行路径。所以链路追踪不只是调试的辅助工具,它是还原事件真实发生过程的唯一证据。
我重点关注三件事。第一,智能体决定做什么——调用哪些工具,按什么顺序,用什么参数?一个工具从未被调用或者总是被错误调用,问题往往出在工具描述,而不是模型本身。第二,时间和金钱花在了哪里。一次范围界定不当的语义搜索可能把五万个 token 拖进上下文,而这种情况只能通过链路追踪才能发现。第三,审计追踪。如果智能体在生产环境修改了某些东西,最终有人会问是谁批准的,而“是 AI 干的”不是一个可接受的答案。